

OfferBoxの適性診断を比較|AnalyzeU+と360度の違い
MoEとは?仕組みとDenseとの違いを就活向けに解説
tennis0709closs@gmail.com
記事内に商品プロモーションを含む場合があります
MoEという言葉をAIのニュースで見かけても、「専門家を組み合わせる仕組み」と聞くだけでは、モデルの中で何が起きているのか想像しにくいかもしれません。
MoEを理解するときは、モデルが持つ規模と、一度の処理に使う規模を分けて考えましょう。計算を抑える仕組みが分かると、「大きいのに速い」という説明をそのまま受け取らず、比較の条件まで確かめられます。
本記事では、LLMで使われるMoEの仕組みを、Denseとの違い、ルーターの働き、パラメータ数の読み方から解説します。最後に、就活で利点と条件をセットで伝える説明例も紹介します。
【Contents】
MoEとは、使う計算部分を入力に応じて選ぶ仕組み
MoEはMixture of Expertsの略で、複数のエキスパートを組み合わせる設計です。本記事では、現代のLLMで使われる、トークンごとに一部のエキスパートを選ぶ疎なMoEを取り上げます。エキスパートとは人間ではなく、学習によって重みを調整する部分的なニューラルネットワークです。
LLMの内部には、入力の数値表現を変換するFFNという計算部分があります。DenseのFFNでは共通の計算経路を使うのに対し、疎なMoEの層では候補のエキスパートから一部を選んで計算します。入力ごとに使う部分を変える点が違いです。
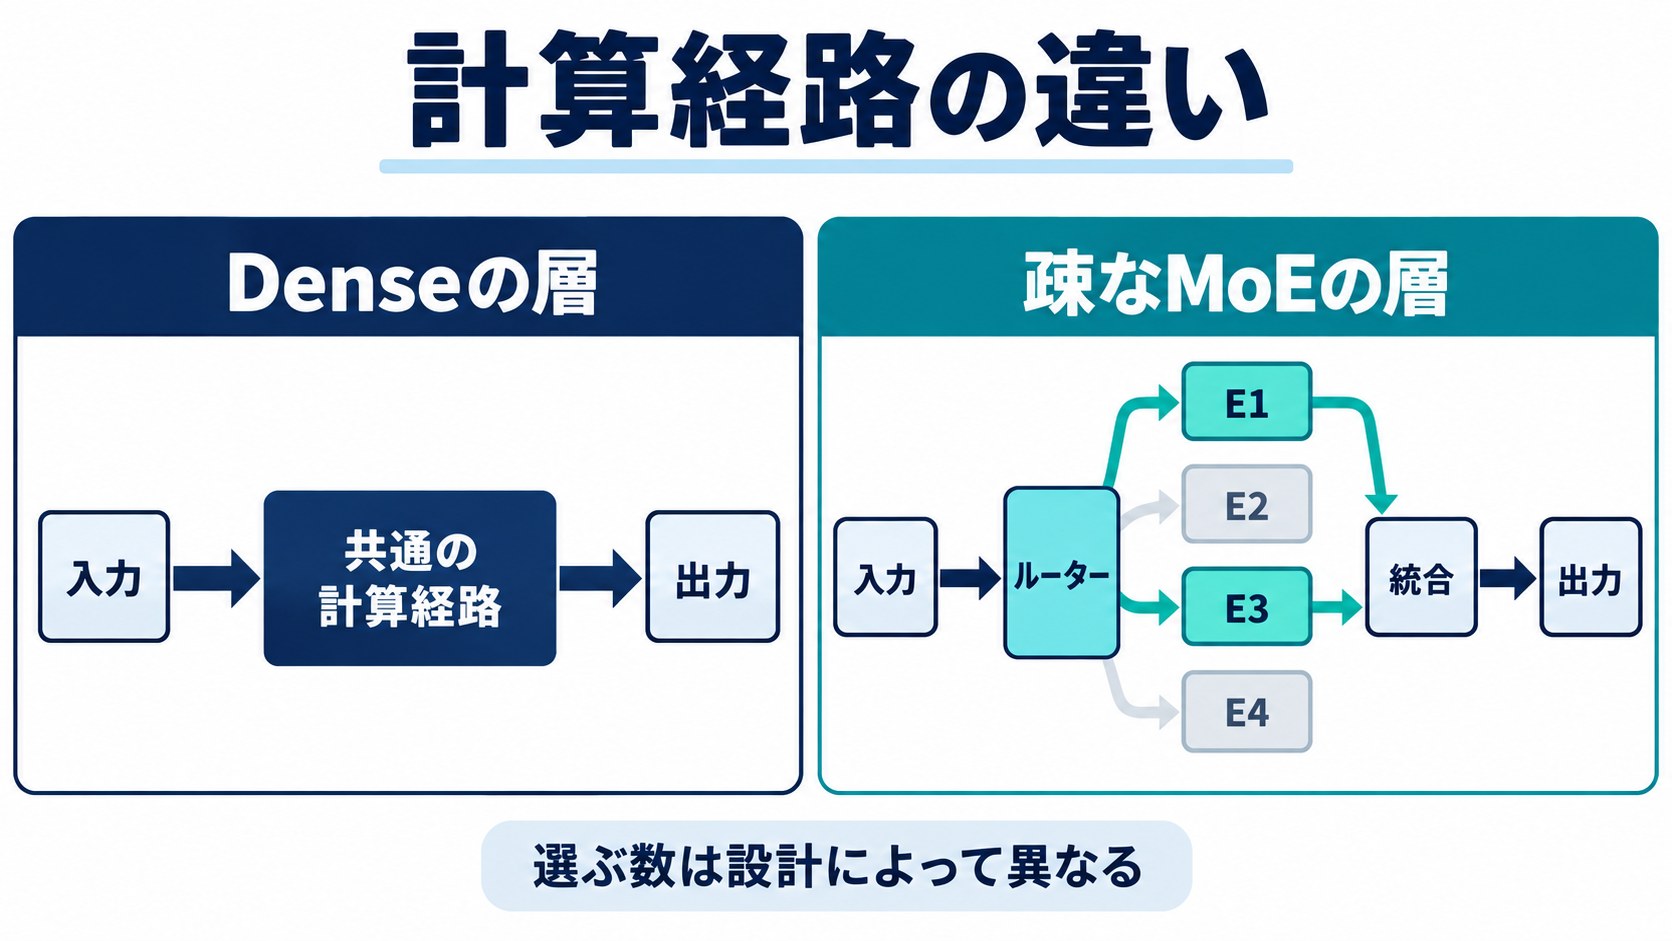
この設計では、エキスパートを増やしてモデルが持つ容量を大きくしても、その全てを毎回計算する必要はありません。ただし、文章中の関係を扱うAttentionなどの共有部分までなくなるわけではなく、モデル全体を独立したAIに分割する仕組みでもありません。
まずは「何を持っているか」と「どこを動かすか」を分けて理解してください。MoEという名前だけから、必ずDenseより高速・高精度だと決めるのではなく、選択する処理と残る処理を追うことが理解の出発点です。
MoEの計算は選択と統合で進む
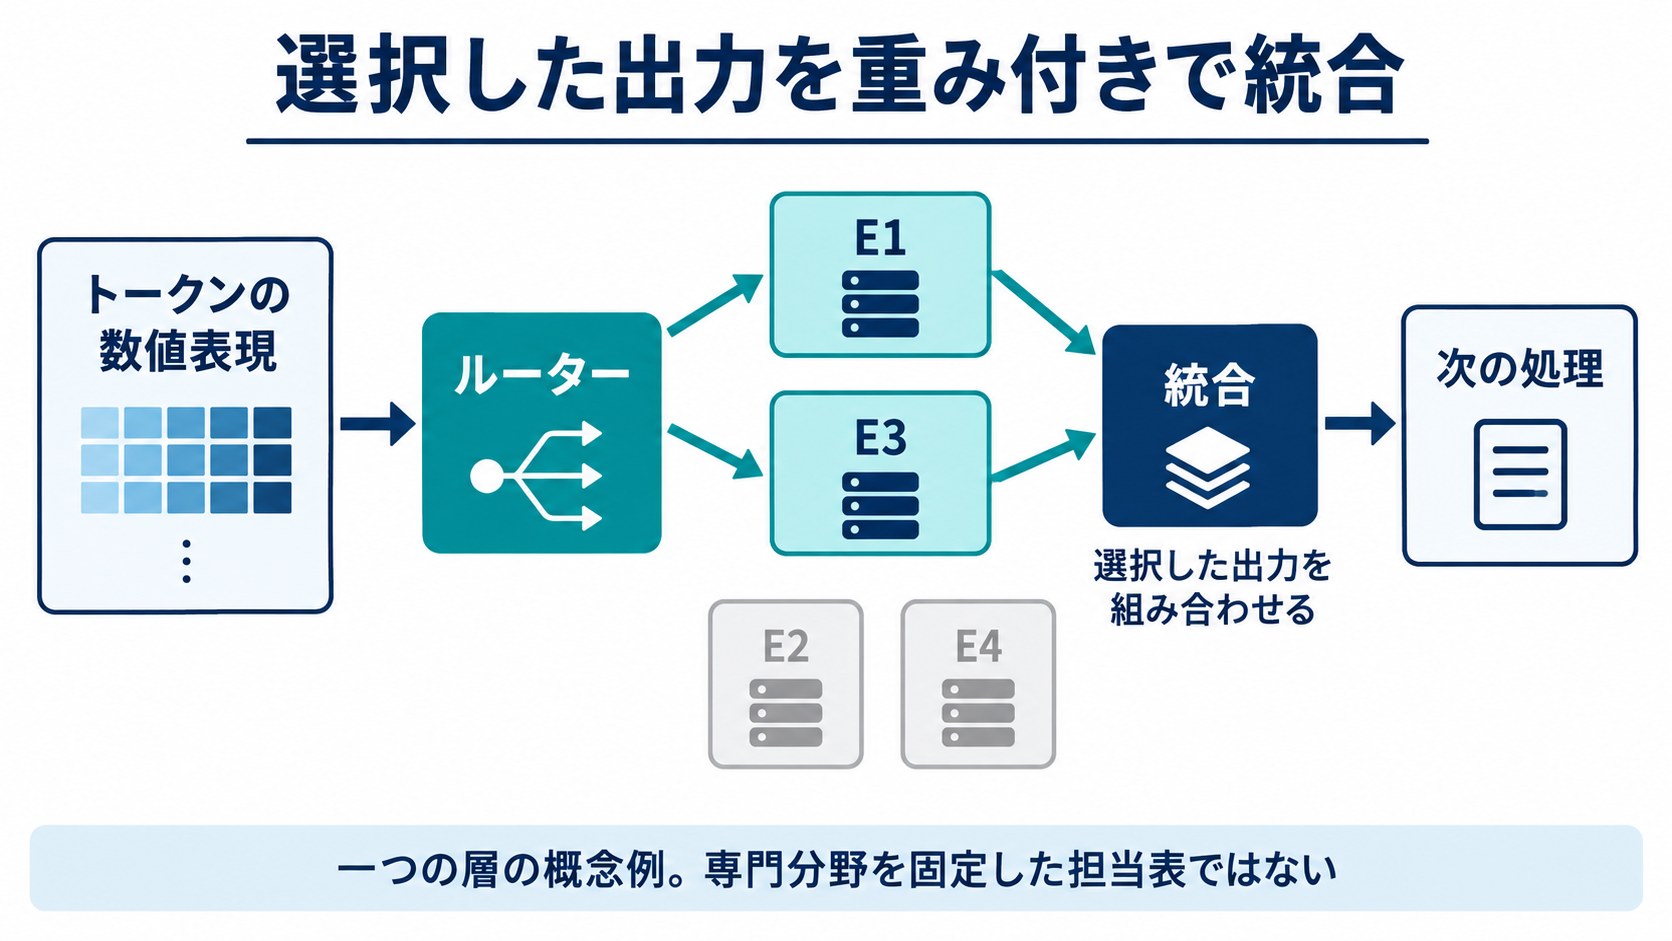
MoEの層では、ルーターが処理先を選び、選ばれたエキスパートが計算した結果を組み合わせます。文章全体を一人の担当へ渡すイメージではなく、トークンを表す数値が層ごとにどう流れるかを見ていきましょう。
- ルーターが処理するエキスパートを選ぶ
- 選んだエキスパートの出力を統合する
ルーターがトークンごとにエキスパートを選ぶ
ルーターは、入力されたトークンの数値表現をもとに、どのエキスパートを使うかを決める部分です。トークンは文章を処理する単位で、必ずしも一単語とは一致しません。一つの単語を複数に分ける場合もあります。
本記事で扱う方式では、選択はトークンごと、MoEの層ごとに行います。ルーターも学習の対象であり、人が質問のジャンルを見て毎回担当を指定するわけではありません。選ぶ数はモデルの設計によって異なり、常に二つとは限りません。
たとえば、あるトークンではE1とE3、別のトークンではE2とE4を選ぶ、という流れを考えられます。これは動きを理解するための仮例です。「一つの質問を一つの専門AIへ丸投げする」と考えず、層の中で計算経路を選ぶ仕組みとして捉えましょう。
選んだエキスパートの出力を組み合わせる
選ばれたエキスパートは、それぞれの重みを使って入力の数値表現を変換します。選んだ出力を重み付きで扱い、次の処理へ渡します。複数を選ぶ方式では、それぞれの出力を組み合わせて、層としての結果を作ります。選ぶ数が一つの方式もあり、全てのMoEで複数の出力が必要なわけではありません。
「エキスパート」という名前から、数学担当や英語担当が最初から決まっていると想像するかもしれません。しかし、役割は学習や設計によって変わり、そのような固定の担当表があるとは限りません。学習による専門化が起こり得ることと、人が分野を割り当てることは別です。
説明するときは、「専門家」という比喩だけで終わらず、実体は学習可能な部分ネットワークだと補足してください。
MoEの効率は3つの観点で比べる
MoEの説明では、総パラメータ数、有効パラメータ数、速度などの数字が並びます。それぞれが表すものを分けると、計算上の利点と、運用するときに残る条件を整理できます。
総パラメータ数と有効パラメータ数を分ける
パラメータは、モデルが学習によって調整する重みなどの値です。総パラメータ数はモデル全体が持つ規模、有効パラメータ数は一つのトークンの処理に使う規模を表します。両者を分けると、大きな容量を持ちながら毎回の計算を抑える仕組みを読み取れます。
有効パラメータには、選んだエキスパート以外の共有部分も含みます。四つの候補から二つを選ぶ仮例でも、モデル全体の計算が半分になるとは限りません。エキスパートの個数と、パラメータの数は同じ単位ではないためです。
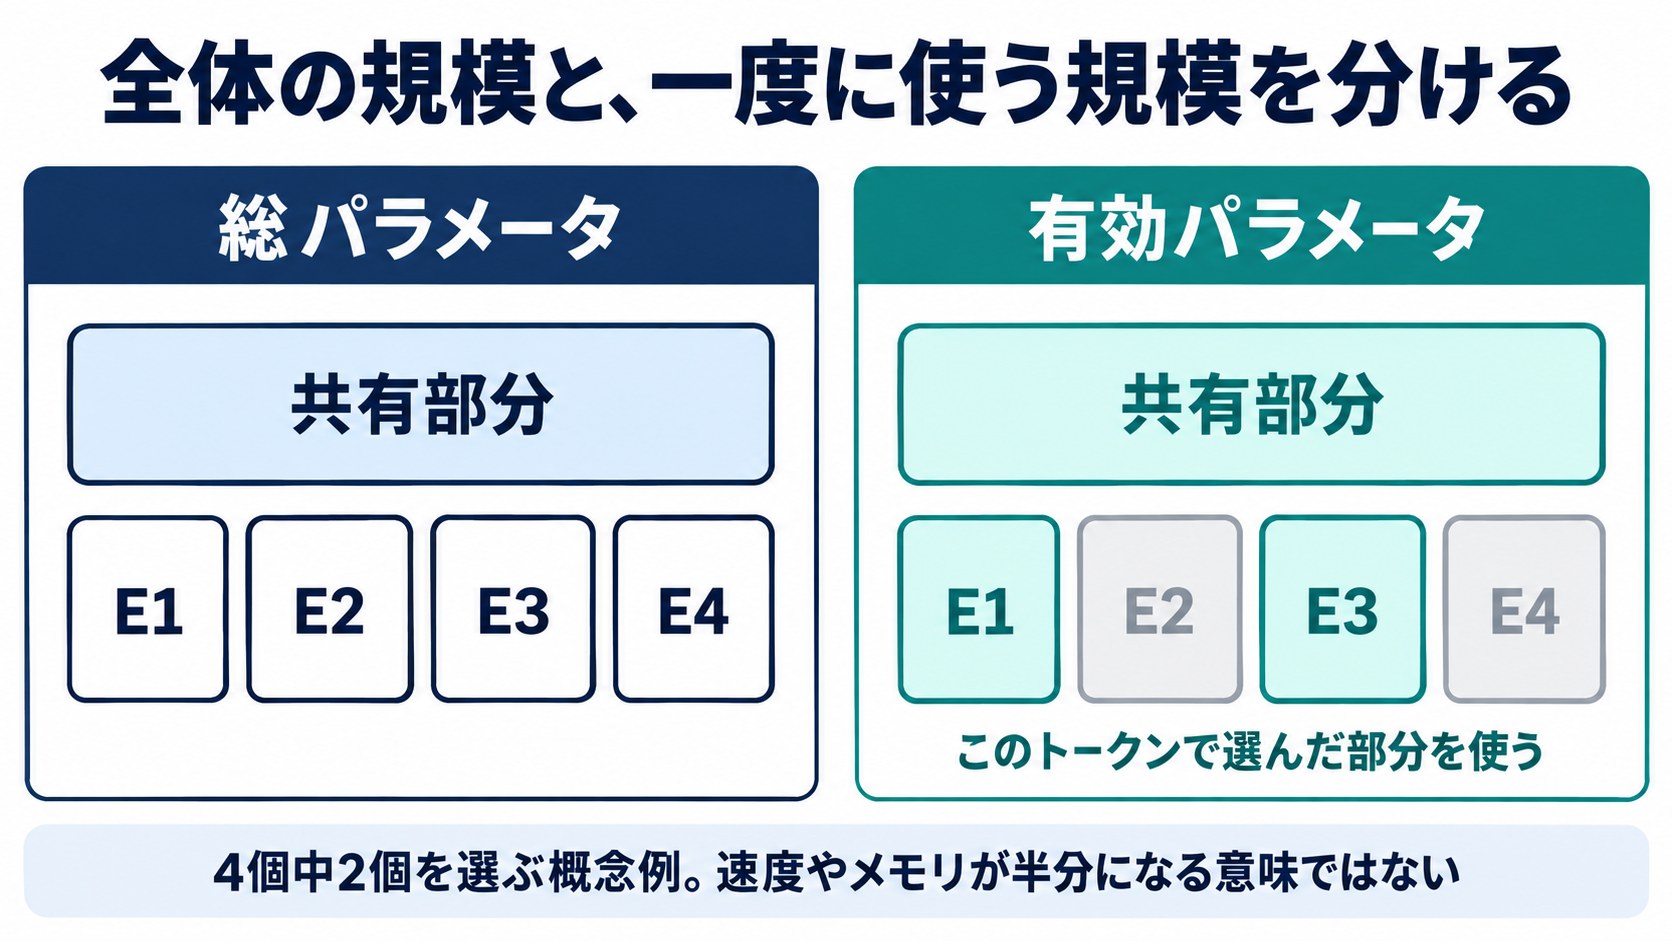
モデルの紹介を読む際は、数字が総数なのか有効数なのかを、比較前に確かめましょう。総数だけで計算の重さを決めたり、有効数だけで保存に必要な容量を見積もったりすると、別の性質を一つの数字で判断してしまいます。
計算量が減っても必要メモリは別に考える
ある処理で選ばなかったエキスパートも、モデルの一部として重みを持っています。別のトークンで選ぶ可能性があるため、今回計算しなかったからといって、その重み自体が不要になるわけではありません。
全ての重みを保持する通常の構成では、必要なメモリを有効パラメータ数だけから算定できません。計算する部分が少ないことと、保持するデータが少ないことは別です。実際の配置は構成によって異なり、必ず一枚のGPUに全てを載せる、という意味でもありません。
たとえば「二つだけ使うなら、残り二つの保存場所はいらない」と考えるのは飛躍です。MoEの利点を伝える際は、計算量の話とメモリ要件の話を別々に説明してください。これだけでも、使う部分を選ぶ仕組みを、モデルそのものを小さくする仕組みと混同しにくくなります。
処理の偏りや通信も実際の速度を左右する
MoEでは処理が特定のエキスパートへ偏ると、待ち時間が増えることがあります。複数の機器に分けて動かす場合にはデータの受け渡しが必要になり、ルーター自身の処理も残ります。計算する重みの規模だけでなく、偏りや通信、実装も実際の速度に影響します。
Denseと比べるときも、総パラメータ数が近いモデル同士なのか、有効パラメータ数が近いモデル同士なのかで、比較の意味は変わります。実測速度を見るなら、機器、数値精度、入力の長さ、一度に処理する量なども確認する必要があります。
「MoEだから速い」で止めず、何と、どの条件で比べた結果かまで読みましょう。速度や費用、回答品質は同じ指標ではありません。一つのモデルで得た結果を、全てのMoEに共通する性能として広げないことが大切です。
就活ではMoEの利点と条件をセットで説明する
就活でMoEを説明するなら、仕組みの名前を列挙するより、どの課題に対する工夫なのかを伝えると話の筋が通ります。「一部を選ぶ仕組み」「計算上の利点」「残る条件」の順で、自分が理解した範囲を説明しましょう。数学式や製品名を増やすこと自体を目標にする必要はありません。
たとえば、モデルの容量を増やしながら毎回使う計算を抑える狙いを述べ、その後にメモリや通信の話を加えます。「高速です」と言い切るのではなく、比較条件で結果が変わると伝えることで、利点だけを取り出した説明を避けられます。
また、論文や解説を読んだことと、モデルを学習・運用した経験は別です。実装していない場合は、読んで理解した内容として話してください。未検証の部分を問われたら、どこまで確認したかを示し、今後は何を確かめたいかにつなげれば十分です。
次の例は、実際の選考で評価された回答ではなく、説明を組み立てるための仮例です。丸暗記よりも、「使わない重みはどこへ行くのか」「速さは何と比べたのか」に自分の言葉で答えられるかを確かめましょう。ニュース全般の選び方や回答の組立ては、別記事で詳しく紹介しています。
MoEを説明する仮例
MoEは、トークンごとに一部のエキスパートを選んで計算する仕組みです。モデルが持つ容量と毎回使う計算を分けられる点に関心を持ちました。ただし、使わない重みも保持する構成ではメモリが必要で、通信や処理の偏りも速度に影響します。私は現時点では仕組みを学んだ段階で、学習や運用の経験とは分けて理解しています。
あわせて読みたい
IT就活で気になるニュースの選び方・答え方と回答例3つ
参考資料


ABOUT ME

IT就活のWebマーケティング領域を支援してきました。
よくあるプログラミングスクールをはじめたら「月収100万円」みたいな嘘のマーケティング活動をしている会社に嫌気が指す思いでいたので、当ブログを設立。
未来を担う学生が、大人に食い物にされないように、「IT就活における社会の真理」をお伝えするブログです。
よくあるプログラミングスクールをはじめたら「月収100万円」みたいな嘘のマーケティング活動をしている会社に嫌気が指す思いでいたので、当ブログを設立。
未来を担う学生が、大人に食い物にされないように、「IT就活における社会の真理」をお伝えするブログです。